监控、告警与审计
平台日志与审计链校验、Prometheus 指标抓取与告警规则、Grafana 仪表盘、平台健康事件通知、告警升级链与 AI 成本预算。
概述
可观测性分为四层:
- 平台日志(操作审计):谁在什么时候做了什么,产品内查看,可校验防篡改。
- Prometheus 指标:业务与框架指标,供外部监控系统抓取和告警。
- 平台健康事件:产品自己发现元数据库掉线、租约丢失等异常后,经通知渠道主动通知(需开启)。
- 告警升级链:任务、管道、检测失败后长时间未恢复的逐级提醒。
平台日志
权限与入口:
ops:view。菜单:运维 → 平台日志
平台日志是操作审计:记录写请求、失败请求与关键业务事件,包括操作人、来源 IP、请求 ID、模块、结果与耗时,可按来源、级别、时间范围和关键字筛选,也能导出。保留期由部署配置决定(默认 90 天)。「校验审计链」会逐行重算审计记录的哈希并与平台保存的链头比对,用来发现被编辑、删除或重排的审计记录。
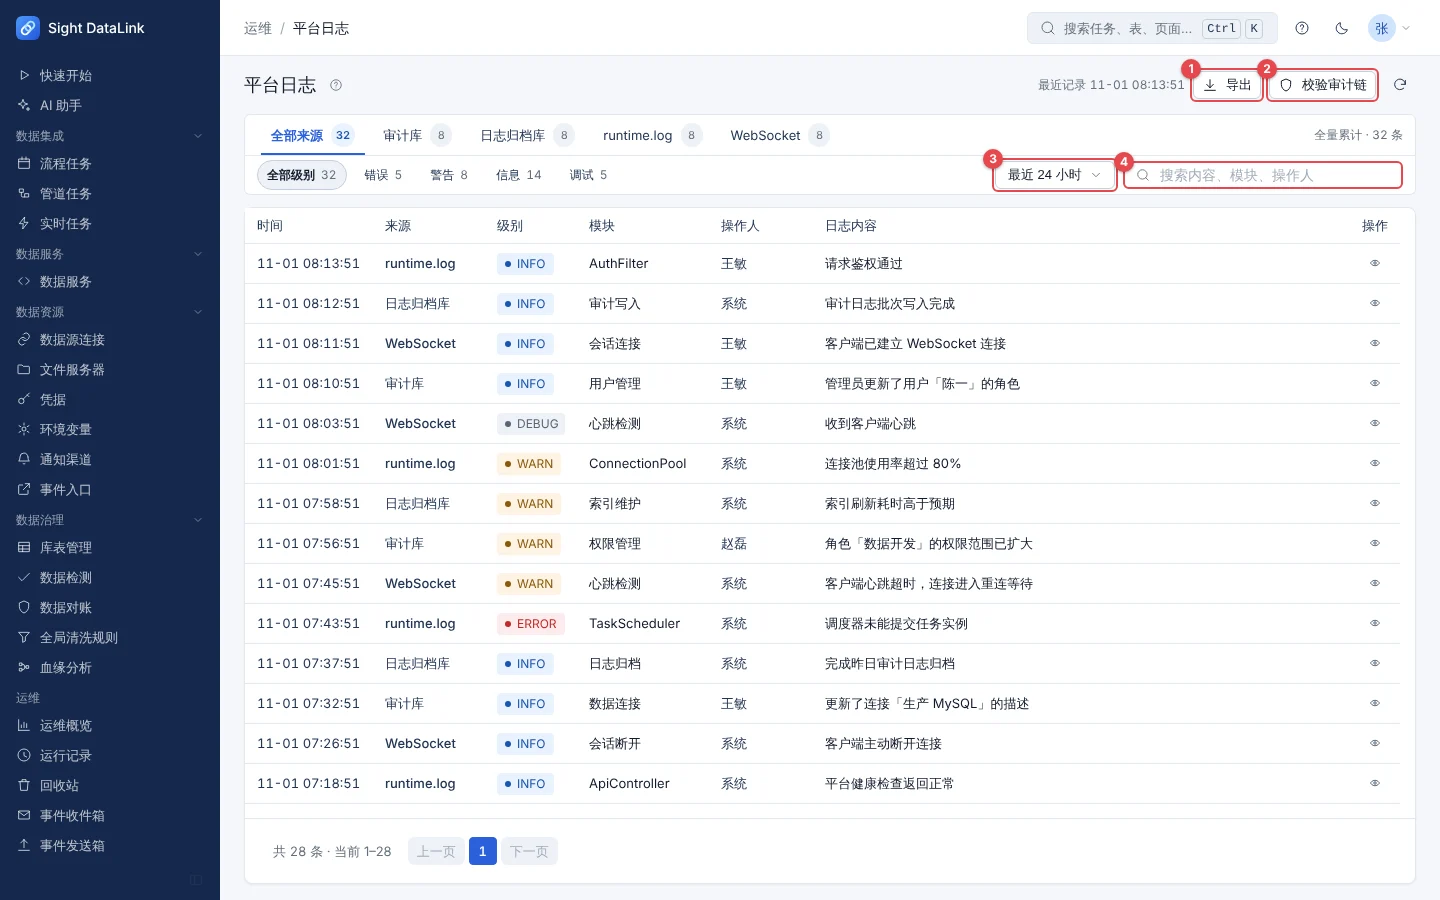
图:平台日志
图中编号说明:
- 导出:把当前筛选范围内的日志导出成文件。
- 校验审计链:重算审计记录的哈希链,检查有没有被篡改。
- 时间范围:默认最近 24 小时,可以改成更长的范围。
- 搜索:按内容、模块或操作人查找;上方还有按来源、按级别(错误 / 警告 / 信息 / 调试)的筛选条。
抓取 Prometheus 指标
- 指标端点:
GET /api/system/actuator/prometheus(Prometheus 文本格式)。Actuator 自带 HTTP 端点整体禁用,指标走受鉴权 API,没有额外暴露面。 - 需要
ops:view权限(内置「运维」角色)。推荐用只读访问令牌作为抓取凭据:在账号菜单的「MCP 接入」页新建令牌(范围选「只读」,账号需有ops:view),只读令牌只保留各模块的查看权限,不能改任何配置。不要用管理员账号密码做 Basic 抓取。 - 令牌撤销或轮换后同步修改 Prometheus 配置,建议每 90 天轮换一次。
- 集群部署时每个实例各自抓取(指标是进程内的)。
scrape_configs:
  - job_name: sight-datalink
    metrics_path: /api/system/actuator/prometheus
    scheme: http
    scrape_interval: 30s
    scrape_timeout: 10s
    http_headers:
      Authorization:
        type: Bearer
        credentials_file: /etc/prometheus/sight-datalink.token   # 内容是一枚 ops:view 只读令牌
    static_configs:
      - targets: ["127.0.0.1:18680"]
        labels:
          cluster: prod
          env: prod
    # 多实例:把每台实例加进 targets,用 instance / cluster 标签区分
手工验证抓取与凭据(不要把令牌写进 shell 历史):
TOKEN='<ops:view 只读令牌>'
curl -sS -H "Authorization: Bearer $TOKEN" http://127.0.0.1:18680/api/system/actuator/prometheus | head
# 预期 HTTP 200;401/403 说明令牌无效或缺少 ops:view
安全:指标里包含实例地址、连接池名称等运维元数据,不应公开暴露。Prometheus 与抓取令牌按内部运维系统保护,不要把
/api端口直接放到公网。
指标清单
业务指标(fdl_*)
| 指标 | 类型 | 含义 |
|---|---|---|
fdl_runs_finished_total |
counter | 已结束的运行数;标签 module=task|pipeline|detect 与 status;失败率的主指标 |
fdl_executor_queued |
gauge | 执行器等待队列长度 |
fdl_executor_active |
gauge | 正在执行的数量,与 queued 一起判断容量是否饱和 |
fdl_executor_rejected_total |
counter | 因线程池或队列饱和被拒绝的次数,增长说明容量不足或积压 |
fdl_outbox_pending |
gauge | 事件发送箱待发送条数(任务/管道/检测告警、通知节点) |
fdl_inbox_pending |
gauge | 事件收件箱待消费条数(Webhook / Kafka / 钉钉 / RabbitMQ 等入站事件) |
fdl_pipeline_lag_seconds |
gauge | 增量 / 实时同步延迟(秒),标签 module=pipeline|realtime、object=<管道 id>。pipeline 为最近一次增量水位推进距今;realtime 为 worker 上报的 CDC 延迟 |
fdl_lease_age_seconds |
gauge | 集群调度租约年龄:有效时为 0,过期后为距过期的秒数;单实例不导出 |
fdl_runs_waiting |
gauge | 等待中的运行数,标签 module |
fdl_event_source_connected |
gauge | 事件入口连通性,标签 kind:1 为所有启用的出站入口均已连接,0 为至少一个断连 |
fdl_mcp_tool_calls_total |
counter | 平台 MCP 工具调用次数(tool / status) |
fdl_alert_escalated_total |
counter | 告警升级提醒次数(level=2|3|4) |
fdl_ai_tokens_total |
counter | AI 辅助消耗的 token 累计 |
延迟、租约、等待运行和事件入口这几个 gauge 是缓存值,默认 30 秒刷新一次(FDL_METRICS_GAP_REFRESH_MS),抓取本身不查库。集群里各实例读取同一个元数据库,导出的值相同:聚合请用 max,不要 sum。
指标名与标签以当前版本实际导出为准:curl .../prometheus | grep fdl_。
框架指标
| 指标 | 用途 |
|---|---|
http_server_requests_seconds_count{status,uri,method} |
接口请求量与状态码,5xx 比例、慢接口 |
jvm_memory_used_bytes{area="heap"}、jvm_memory_max_bytes |
堆使用率,接近上限会 OOM 重启 |
jvm_gc_pause_seconds_*、jvm_threads_live_threads |
GC 与线程排查 |
hikaricp_connections_* |
元数据库连接池占用与等待 |
process_cpu_usage、system_cpu_usage |
进程与主机 CPU |
告警规则与处置
随产品提供的示例规则 prometheus-rules.yml(位于发布包 deploy/observability/)默认使用 job="sight-datalink",阈值是保守起点,请按自己的数据量与 SLO 调整。通知路由(Alertmanager、邮件、钉钉、企业微信)需部署方接入;产品内置通知渠道只用于任务、管道、检测的告警与通知节点。
Grafana 仪表盘
- Grafana > Dashboards > Import,上传随产品提供的
grafana-dashboard.json(发布包deploy/observability/)。 - 选择 Prometheus 数据源(变量
DS_PROMETHEUS)。 - 默认时间范围 6 小时、30 秒刷新;面板包括运行失败率、运行完成速率、执行器排队与拒绝、发送箱与收件箱积压、HTTP 5xx 比例、JVM 堆、AI token 用量和抓取状态。
- 某个面板为空时,先在 Prometheus 里执行面板上的表达式确认指标存在。
日常巡检建议
- 每天:失败率、发送箱与收件箱积压、
fdl_pipeline_lag_seconds最大值、fdl_runs_waiting、fdl_event_source_connected、抓取up是否全为 1。 - 每周:JVM 堆与连接池趋势、AI token 周用量、5xx 比例最高的接口。
- 每月:校准告警阈值,确认令牌与证书有效期。
- 每次升级后:确认指标仍可抓取(见 升级与回滚)。
已知边界
- 延迟指标只到管道和实时任务粒度,不等于目标端可见延迟;逐表延迟、对账进度没有独立指标,需要从运行记录与管道「同步状态」核对。
- 平台健康事件通知默认关闭,开启后只覆盖下文几类转换事件,外部 Prometheus 告警仍需作为兜底。
- 指标按实例导出,集群里不要把
fdl_executor_queued直接sum当作全局排队。 - 没有分布式追踪导出(OTel / Jaeger),只有日志中的
requestId/traceId/runId关联。
平台健康事件通知
产品自身的健康事件可以通过通知渠道发出,默认关闭。它与 Prometheus 告警互补:Prometheus 负责外部可观测,这一项负责平台自己发现异常后主动通知。
| 变量 | 默认 | 说明 |
|---|---|---|
FDL_PLATFORM_ALERTS_ENABLED |
false |
总开关;关闭时不做任何探测 |
FDL_PLATFORM_ALERTS_CHANNEL_IDS |
空 | 通知渠道 id,逗号分隔;为空表示开启但不发送 |
FDL_PLATFORM_ALERTS_DB_CHECK_MS |
60000 |
元数据库探测间隔 |
FDL_PLATFORM_ALERTS_EVENT_SOURCE_CHECK_MS |
60000 |
事件入口连通性探测间隔 |
| 事件 | 触发条件 | 建议动作 |
|---|---|---|
db_down / db_up |
元数据库探测由可用变为不可用 / 恢复 | 检查 DB_URL、网络、账号、连接池;恢复前平台无法调度、执行或写日志;恢复后核对故障窗口内的运行记录与积压 |
fenced |
本实例失去调度租约 | 检查实例与元数据库网络、GC 暂停、集群成员;必要时重启该实例 |
retention_failed |
平台日志保留清理失败 | 检查服务日志、元数据库空间与权限;下一小时会自动重试 |
event_source_down / event_source_up |
某个启用的出站事件入口断连 / 恢复 | 到「事件入口」页检查连接状态;恢复后核对事件收件箱是否漏收或积压 |
同一事件在同一 UTC 小时对每个渠道最多发一条;事件入口按「入口 + 方向」分别去重。元数据库不可达时发送箱本身也写不进去,所以仍应保留 Prometheus 的 SightDataLinkMetricsMissing 作为兜底。发送明细可在「运维」>「事件发送箱」按来源 platform_alert 筛选,查看、重发或丢弃。
告警 SLA 与升级链
在任务、管道、检测的「告警策略」(运行告警弹窗内)可以为单个对象配置 SLA:失败后超过 slaMinutes 仍未恢复,平台按升级级别(最多 3 组渠道)逐步提醒,级别用尽后按 repeatMinutes 重复最后一级。静默窗口(HH:mm,支持跨午夜)内只记日志不发送,窗口结束后补发;最新一次运行成功视为恢复并重置状态。级别 1 仍是对象原有的失败通知,不需要额外配置。
升级次数可用 fdl_alert_escalated_total{level} 观察,示例规则 SightDataLinkAlertEscalated(近 15 分钟有升级提醒即触发)会把它转给 Prometheus 告警,处置时到对应任务、管道或检测的「告警策略」核对 SLA、升级渠道与静默窗口,频繁触发时先确认值班安排,或调大 slaMinutes / repeatMinutes;静默窗口内没有收到升级属于预期行为;升级消息可在「事件发送箱」按对象名找到。
审计日志防篡改
语义审计记录(谁改了什么:任务、管道、检测定义修改,权限与账号变更,通知渠道与密钥管理,MCP 工具调用等)按写入顺序串成一条哈希链,数据库管理员直接改动或删除记录会被发现,而不是静默通过。
- 哈希:配置了
FDL_CONNECTION_SECRET_KEY时使用 HMAC-SHA256;未配置时退化为 SHA-256,仍能发现误改和普通篡改,但能重算哈希的数据库管理员可以重连链条。 - 保留:审计记录默认保留 180 天(
FDL_AUDIT_RETENTION_DAYS,0 表示永久),到期按顺序从最老的记录剪枝,不会被误报为篡改;请求日志另由FDL_PLATFORM_LOG_RETENTION_DAYS(默认 90 天)控制。 - 历史记录:链功能启用之前写入的审计记录不入链,校验时作为基线跳过,只在
unverifiedHistorical中计数,不算断链。
校验
界面「运维」>「平台日志」的「校验审计链」按钮即可校验。也可以调用接口 GET /api/platform-logs/verify?from&to&limit(需要 ops:view,建议用只读令牌),或用命令行工具:
export DATALINK_URL=http://127.0.0.1:18680
export DATALINK_TOKEN='<ops:view 只读令牌>'

tools/audit-verify.sh                         # 整条链,人读摘要
tools/audit-verify.sh --from 2026-10-01 --to 2026-10-31
tools/audit-verify.sh --limit 20000 --json    # 机器可读
退出码:0 链完整;2 发现断链(输出原因、首个断点 id 与时间);1 参数、网络或鉴权错误。建议放进每日定时任务,并对 2 和 1 分别告警。
| 断链原因 | 含义与动作 |
|---|---|
hash_mismatch |
该行内容或哈希被改过。保留现场(备份审计表),核对同时间窗的其他日志与变更记录;涉及账号、权限、密钥时按安全事件处理 |
chain_link_mismatch |
中间的审计记录被删除,或插入、重排。通过备份差异定位被删记录,该断点之后的链不再可信 |
tail_mismatch |
最新的审计记录被删除,或链头被改写 |
chain_state_missing |
链头记录被删除,需要从备份恢复 |
注意:丢失或更换
FDL_CONNECTION_SECRET_KEY后,旧记录无法重算,校验会报断链。部署密钥必须与元数据库一起备份。哈希链证明的是「持有部署密钥的人之外,审计历史不可静默修改」;需要更强保证时请把审计日志另外导出到不可变存储。
AI 成本预算
AI 辅助的用量按 token 记录,可以配置成本估算与预算告警(默认关闭,单价或预算为 0 时不估算):
| 配置 | 含义 |
|---|---|
FDL_AI_COST_INPUT_PER_1K / FDL_AI_COST_OUTPUT_PER_1K |
每 1000 输入 / 输出 token 的金额 |
FDL_AI_BUDGET_DAILY_AMOUNT / FDL_AI_BUDGET_MONTHLY_AMOUNT |
日 / 月预算金额,0 表示不启用该窗口 |
FDL_AI_BUDGET_CHANNEL_IDS |
达到阈值时通知的渠道 id;为空则只写审计 |
FDL_AI_BUDGET_CHECK_MS |
检查间隔,默认 5 分钟 |
用量达到预算的 80% 与 100% 时各提醒一次(同一窗口、同一周期、同一阈值最多一次),指标为 fdl_ai_budget_used_ratio{window};示例规则 SightDataLinkAiBudgetWarning(比例 ≥ 0.8,持续 15 分钟)与 SightDataLinkAiBudgetExceeded(比例 ≥ 1,持续 5 分钟)基于该指标。预算告警只是成本治理信号,不会自动停用 AI;真正阻断请求的是「管理系统」>「AI 辅助」里的每人每日 token 上限与全站每日 token 上限。超限时先在「AI 辅助」页确认是哪个功能在消耗,再收紧上限或调整预算。详见 AI 辅助与智能体。