管道任务:全量、增量与 CDC 同步
用四步向导创建「来源表 → 目标表」同步:写入模式、同步方式、字段映射与公式、调度告警、脏数据容错与集群行为。
概述
平台提供三种搬运与加工数据的方式,按场景选择:
- 管道任务:一批「来源表 → 目标表」的固定流向;全量、增量、实时(CDC)向导式配置。
- 流程任务:画布编排多个步骤:SQL、同步、HTTP、条件分支、通知……按 cron 或事件触发。
- 实时任务:来源 → 算子链 → 目标,常驻运行,位点只在目标提交后前进。
配管道前想先看看来源库里有哪些表,可以用「数据治理」>「库表管理」,见 数据质量:库表、检测与对账。数据源需要先在 数据源连接 里配好。
权限与入口:
data:view查看;data:edit新建 / 修改 / 运行。菜单:数据集成 → 管道任务
管道是「来源表 → 目标表」的一批同步配置。适合把业务库的表持续搬到数仓这类固定流向;需要复杂分支或调用外部接口请用流程任务,需要秒级持续同步请用实时任务(也可以在向导里直接选「实时」同步方式)。
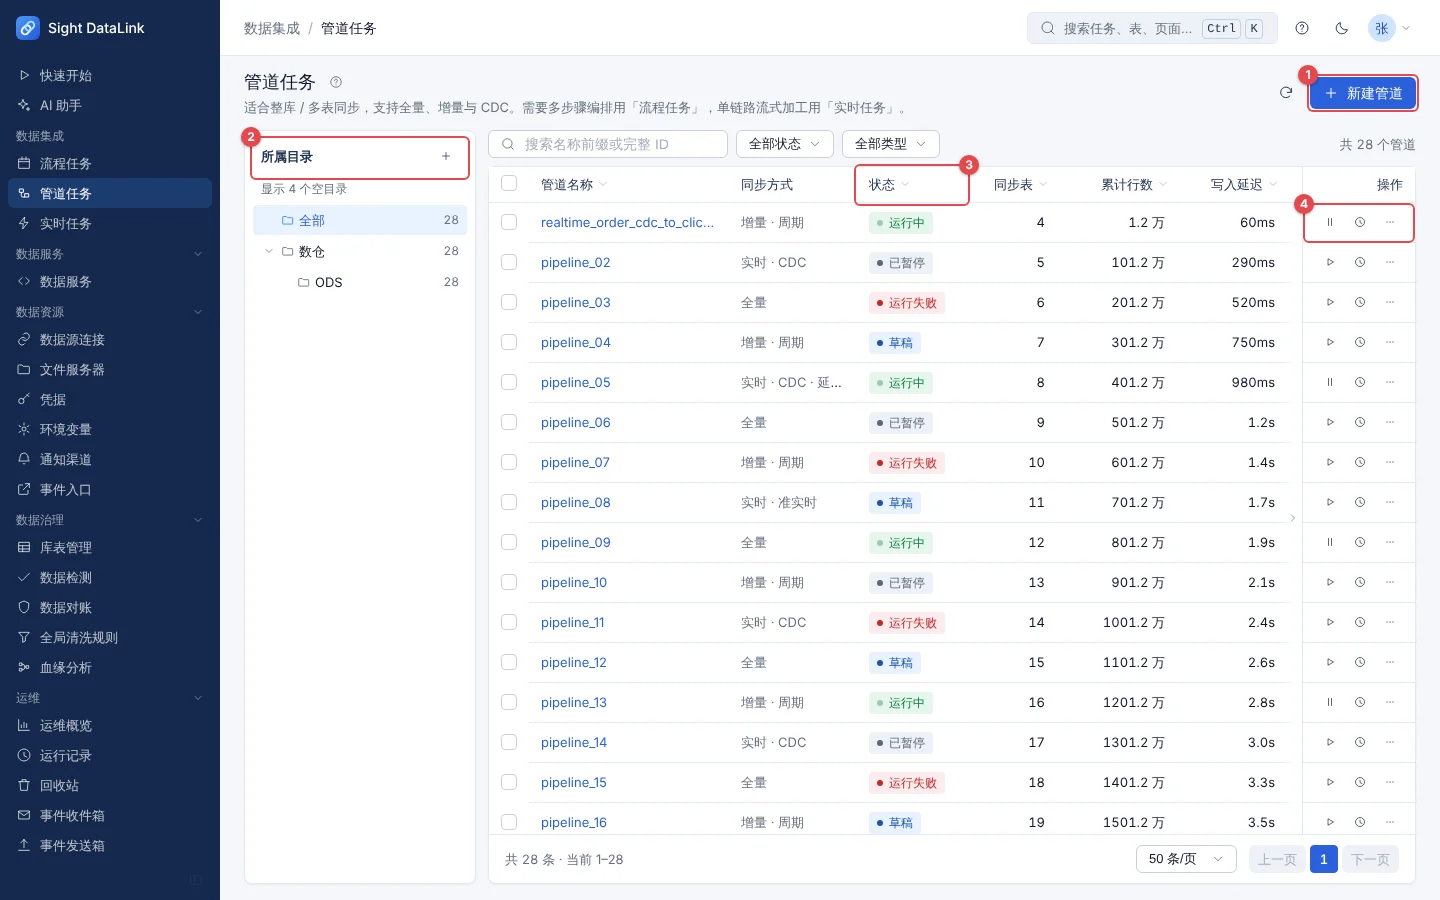
图:管道任务列表
图中编号说明:
- 新建管道:进入四步向导。
- 所属目录:用目录树给管道分组,数字是该目录下的管道数。
- 状态:运行中 / 已暂停 / 运行失败 / 草稿。「同步方式」列区分全量、增量与实时(CDC / 准实时)。
- 操作:启动 / 暂停、运行记录,以及「…」里的更多操作。
列表里还能看到累计同步行数与写入延迟。每行「…」里的操作包括:版本历史(查看生产定义版本、对比并回滚)、按时间窗口补数(补一段来源历史窗口,不推进增量水位 / CDC 位点)、查看同步状态与位点、配置运行告警(失败 / 成功通知)、配置周期计划和删除管道。
新建管道:四步向导
**第 1 步 · 基本信息。**填写名称、所属目录、来源与目标数据源、写入模式和同步方式。
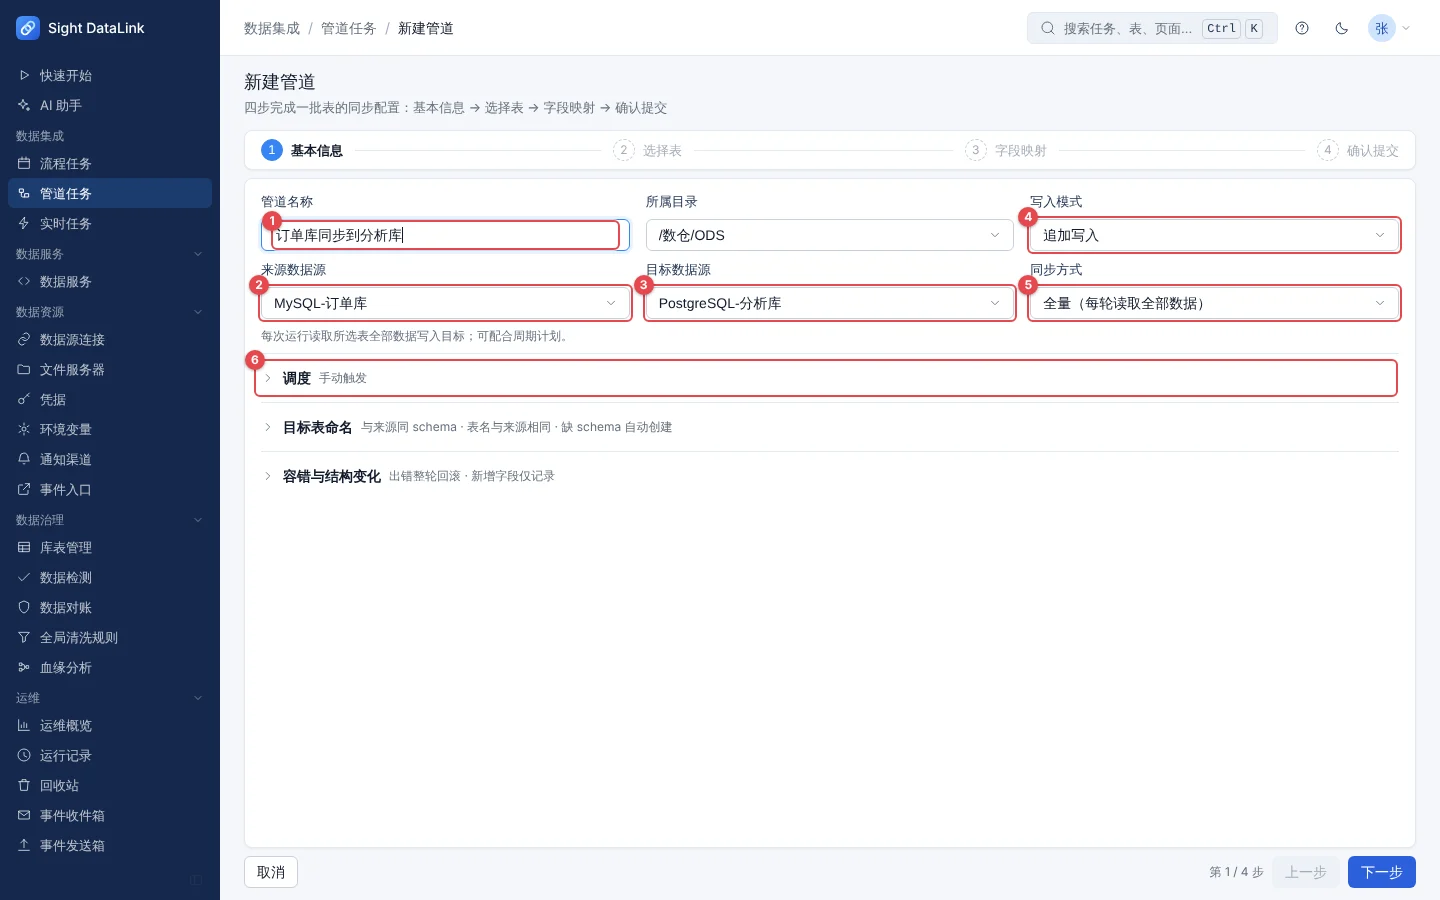
图:向导第 1 步:基本信息
图中编号说明:
- 管道名称。
- 来源数据源:从哪里读。
- 目标数据源:写到哪里。
- 写入模式:追加 / 覆盖 / 主键更新(见下表)。
- 同步方式:全量 / 增量 / 实时。
- 调度、目标表命名、容错与结构变化:三个折叠区,默认收起并在标题后给出当前摘要。
| 写入模式 | 行为 | 注意 |
|---|---|---|
| 追加写入 | 目标表只插入 | 失败重跑或「回看窗口」重放时可能产生重复,运行日志会提示。 |
| 覆盖写入 | 每轮先清空目标同名表,再写入来源全量 | 来源为空也会清空目标;大表耗时较长,注意超时与目标库锁。失败或暂停时整轮回滚。 |
| 主键更新(Upsert) | 按主键插入或更新 | 需要正确的主键映射;「主键幂等」只对它成立。 |
| 同步方式 | 说明 |
|---|---|
| 全量 | 每轮读取所选表的全部数据,适合小表与维表。 |
| 增量 | 按「增量字段」(时间戳 / 自增 ID)只读变化部分,可设置「回看窗口」;水位保存在元数据库,失败后续传。 |
| 实时 | 日志 CDC(PostgreSQL 逻辑复制、MySQL / MariaDB binlog、SQL Server CDC、Oracle)或准实时轮询(可设置轮询间隔秒数)。以 Kafka 为目标时只能选实时。 |
**第 2 步 · 选择表。**页面会读取来源库里的表清单,勾选要同步的表(可以搜索、可全选);字段读取完成前「下一步」不可用,避免用空字段往前走。
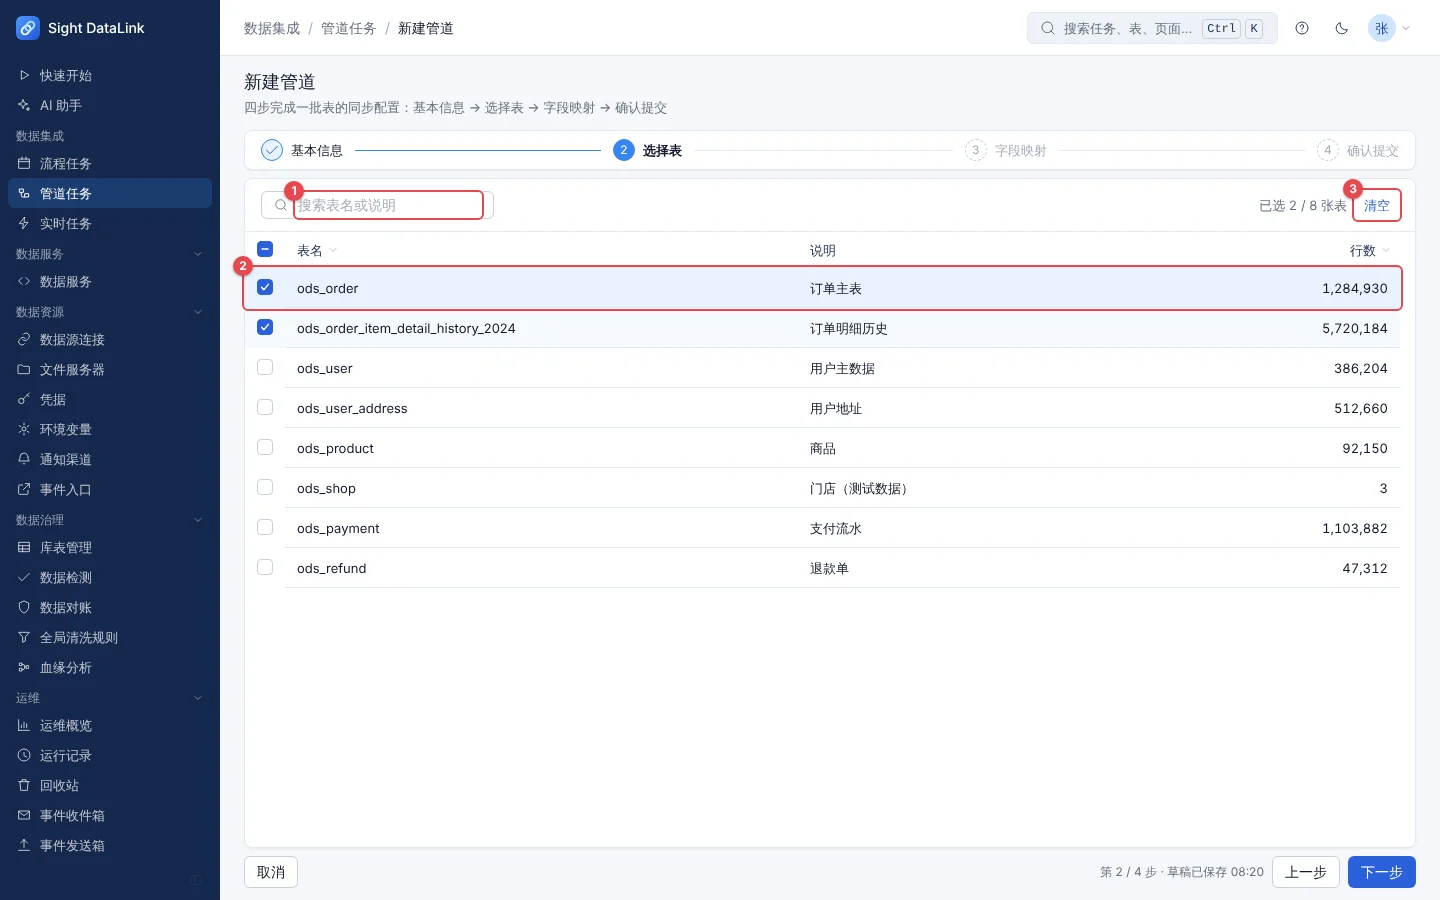
图:向导第 2 步:选择表
图中编号说明:
- 搜索表名或说明。
- 点击行首的复选框勾选表;右上角显示「已选 n / 总数 张表」。
- 清空已选。
第 3 步 · 字段映射。左边是已选的表,右边是当前表的字段映射。每个字段可以启用 / 停用、改目标字段名与类型、指定主键,并选择取值方式:直连来源字段、表达式(公式)、JSON 解析或字段拆列。目标类型默认按来源给出建议,改成有风险的类型时会就地提示。
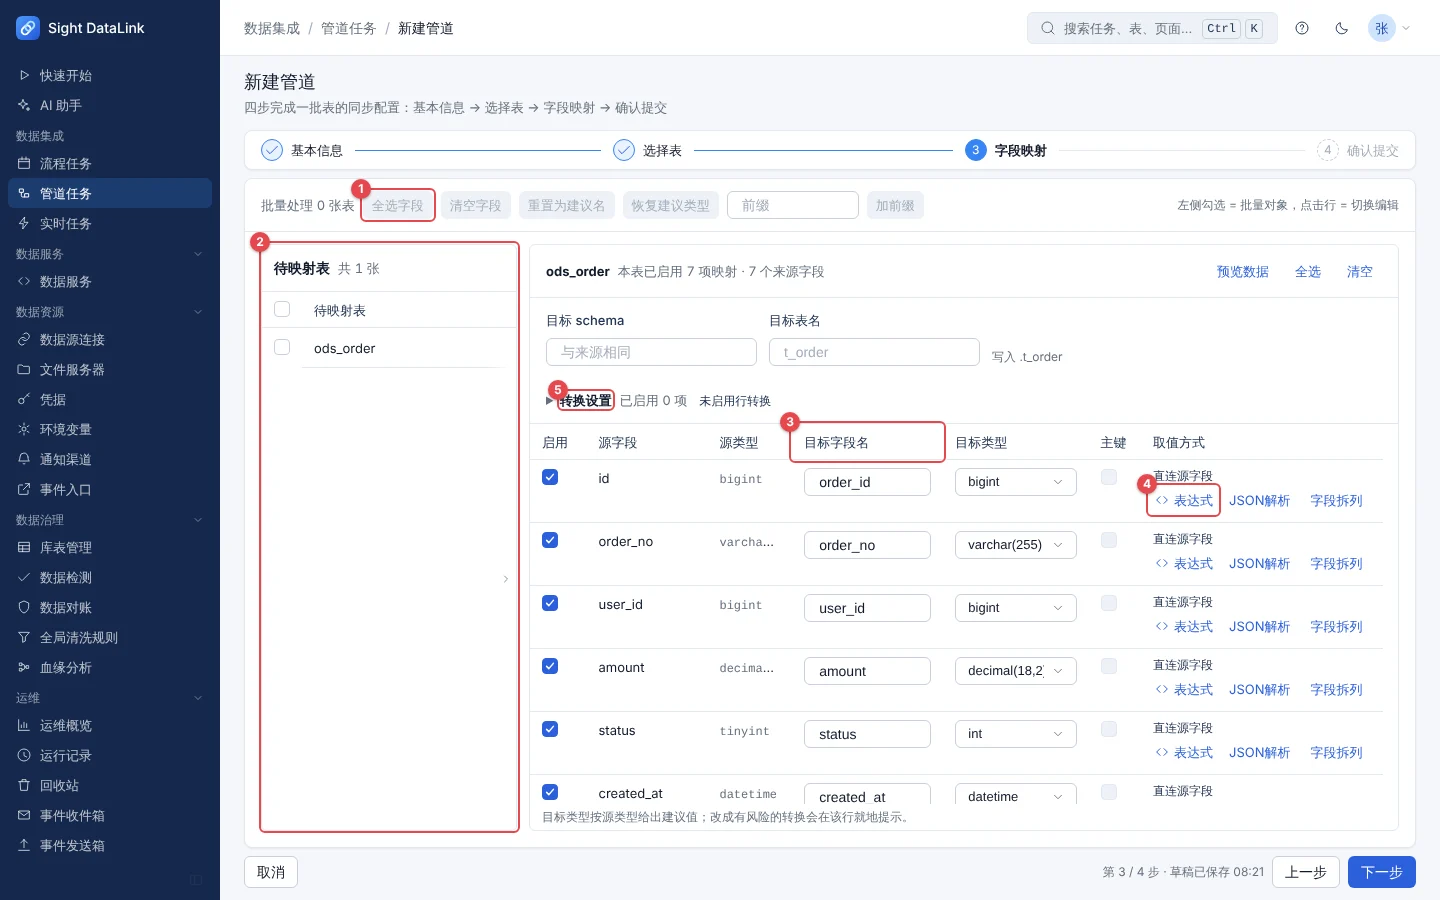
图:向导第 3 步:字段映射
图中编号说明:
- 批量处理:对勾选的多张表一起「全选字段 / 清空字段 / 重置为建议名 / 恢复建议类型 / 加前缀」。
- 待映射表:点击行切换右侧正在编辑的表;复选框用于批量对象。
- 目标字段名:右侧还有目标类型、主键和取值方式。
- 表达式:用公式计算目标字段,例如
UPPER(${order_no})、IF(${amount} > 100, 1, 0)。 - 转换设置:数据关联、上下合并、字段拆行、行转列 / 列转行、分组汇总、转换后过滤等高级处理,默认未启用。
公式:公式引擎在管道字段、任务计算节点、实时任务计算列、全局清洗规则里是同一套:
${字段}引用字段,支持+ - * / %,文本函数(UPPER LOWER TRIM LENGTH CONCAT COALESCE)、数值函数(ABS ROUND)、逻辑函数(IF AND OR NOT ISNULL ISBLANK)和日期函数(TODAY NOW DATE YEAR MONTH DAY HOUR MINUTE WEEKDAY DATEADD DATEDIFF FORMATDATE PARSEDATE)。参数值只当数据参与计算,不会被拼进 SQL。
**第 4 步 · 确认提交。**汇总所有设置(名称、来源与目标、写入与同步方式、脏数据策略、目标表名、调度、各项转换是否启用、同步的表与字段数),页面底部还有「目标侧预览」——每个目标字段对应的来源表达式。确认无误后点「提交」。
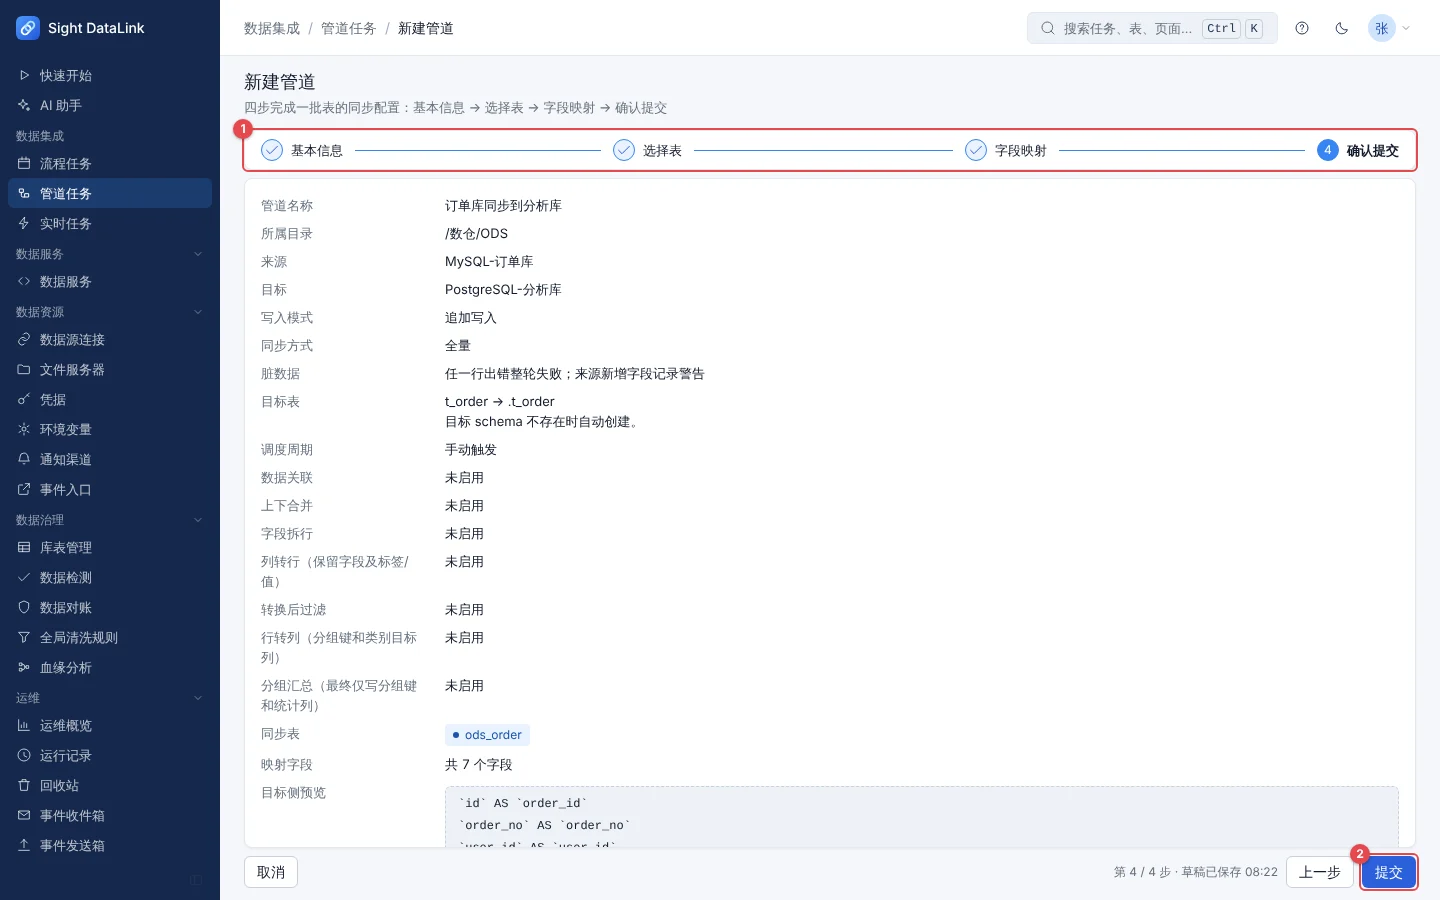
图:向导第 4 步:确认提交
图中编号说明:
- 步骤条:前三步已打勾,当前是第 4 步。
- 提交:保存管道。向导会自动保存草稿(页脚显示「草稿已保存」),中途离开再回来可以继续。
调度、运行与告警
- 调度:第 1 步的「调度」区,或列表行的「配置周期计划」里设置 cron / 「只运行一次」。管道遇到错过的轮次会跳过,不会一口气补跑。
- 手动运行 / 暂停:列表行首的播放 / 暂停按钮。
- 运行记录:点「查看管道运行记录」看每一轮的状态、耗时、写入行数与脏数据,可进入运行日志(运行记录与运行日志)。运行记录默认保留 90 天。
- 告警:「配置运行告警」里选择失败 / 成功时通知哪些渠道(通知渠道)。
- 脏数据与容错:第 1 步的「容错与结构变化」里可选「任一行出错整轮失败(回滚)」或「跳过出错行并记录」(可限制最多脏数据行数 / 比例);「来源新增字段」可选「记录警告」或「自动加入同步并给目标表加列」。
注意:覆盖写入会清空目标表;追加写入遇到重放可能重复;增量水位提示「拒绝续传」时,请先核对目标数据再重置位点,不要直接强行重跑。
增量与时区
- 增量同步按水位字段(时间 / 自增 ID)只读新增部分;水位保存在元数据库,失败续传。
- 带时区的时间戳按 UTC 瞬时保存。旧版本丢失偏移的 PostgreSQL 时区水位会拒绝续传并提示核对后重置,避免静默丢行或重复。
- 目标 schema / 表名可按来源自动生成(同 schema 同名)或自定义;目标表不存在时可自动创建,复杂类型建议先在目标库建表。
集群与运行保留
- 多实例共用一个元数据库时,调度由租约 leader 派发;停止 / 暂停会送到运行所在实例。
- 实例离线后,运行由其他实例接管或标记中断;提交结果未知的 SQL 运行会保留证据,不自动重跑。
- 运行记录默认保留 90 天(
FDL_RUN_RETENTION_DAYS,0 表示永久)。 - 通知渠道的出站目标受 SSRF 防护与
FDL_OUTBOUND_*白名单约束。
相关入口
- 版本与回滚:流程任务有发布版本与历史版本;管道在每行「…」的「版本历史」中查看、对比并回滚。
- 数据对账:按日 / 周 / 月比较来源与目标的行数与合计,见 数据质量:库表、检测与对账。
- 批量迁移配置:
tools/datalink-cli.sh export / import,密码、令牌不写入文件。 - 排错:见 常见问题。